全网吹爆的astra,为什么我觉得它有一种「伪人感」
叮当小鸡毛 2,438 字 · 约 6 分钟 11 张图 · 11 条来源
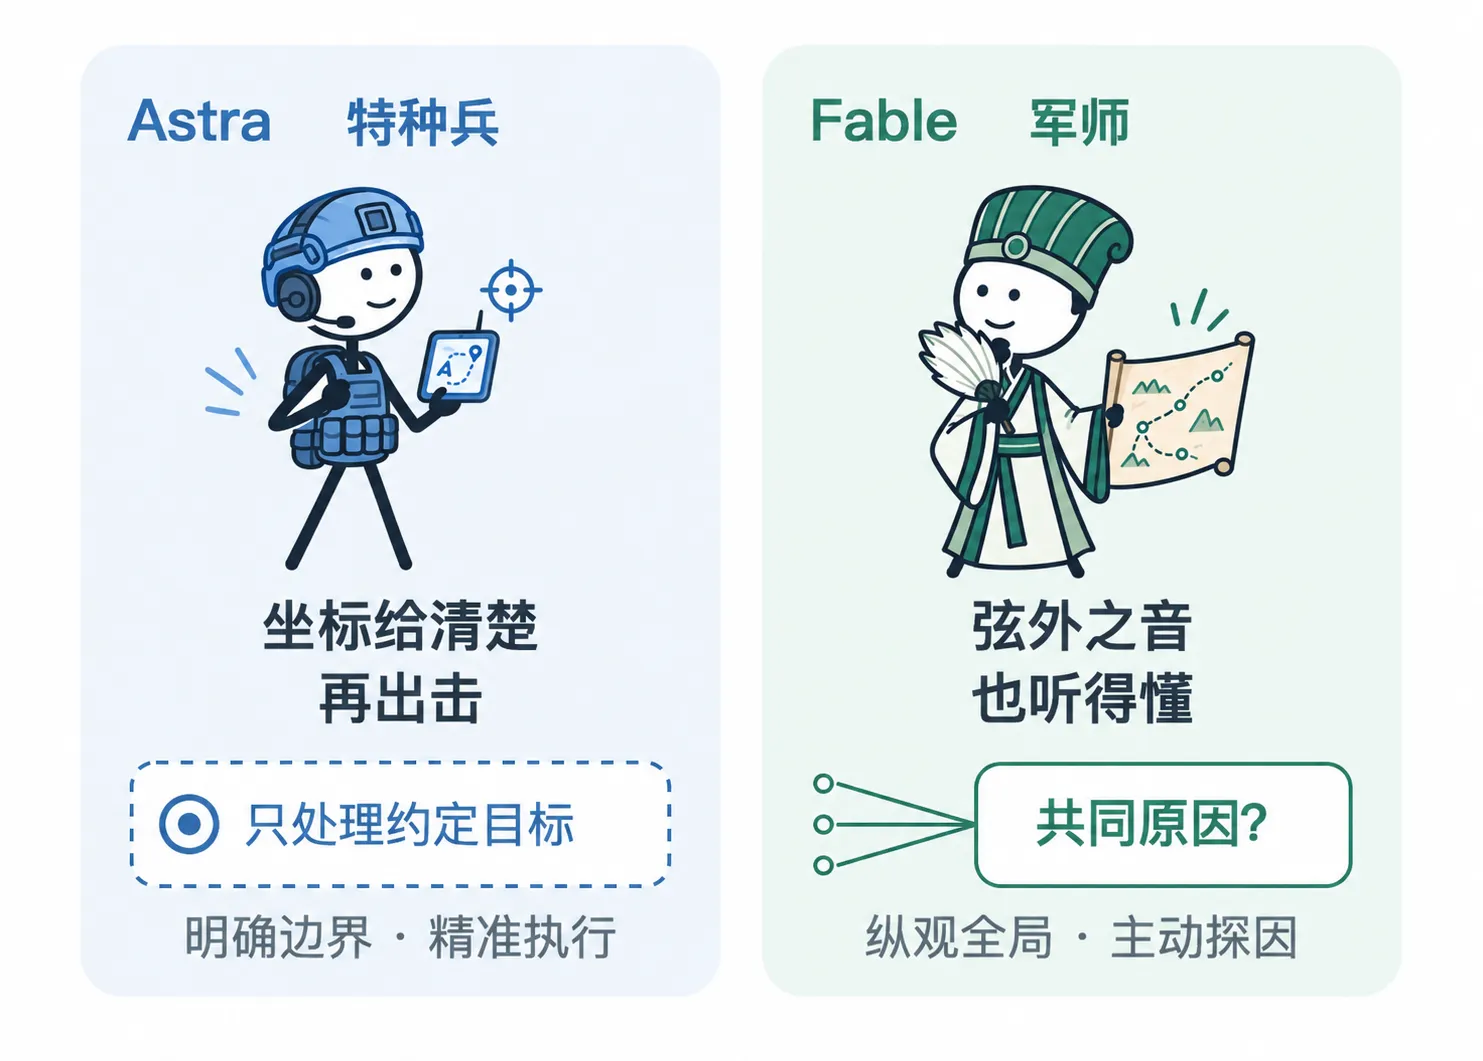
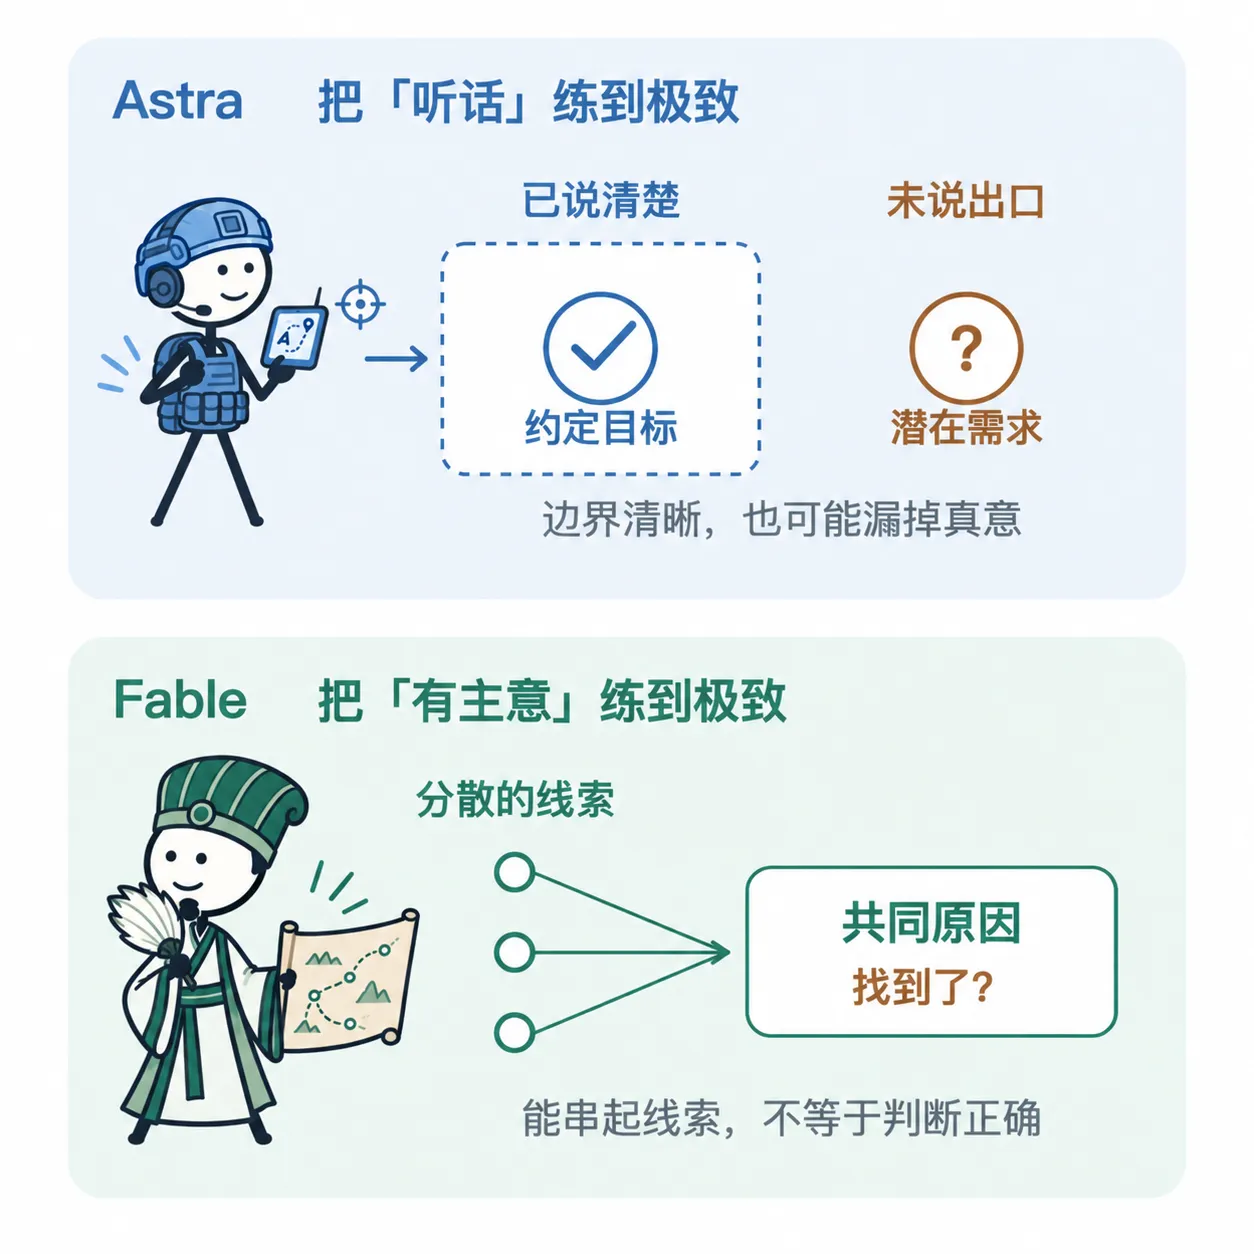
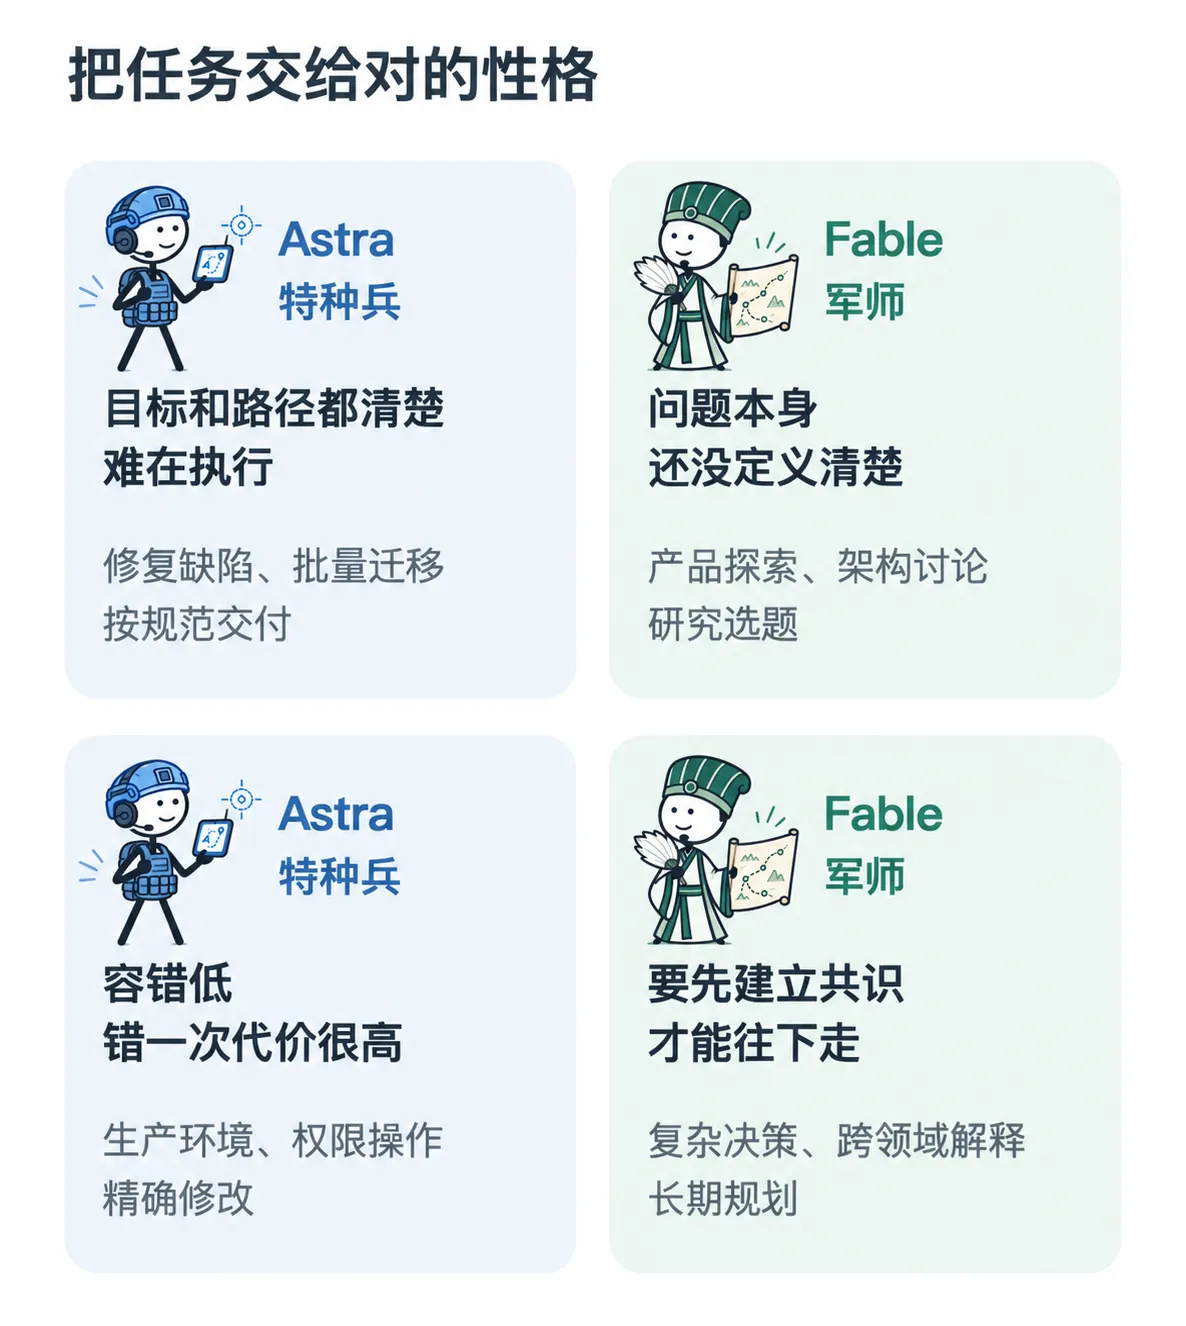
我最近一直在磨合 gpt-6-astra(下文简称 Astra),努力的成果,是开了一个新的 Claude 账号。起初是 Claude 账号被封,恰逢 Astra 上线、全网吹爆,遂立刻订阅。磨合下来,Astra 的确知识密度高,但体验和前代没什么两样:你说的它都做,你不说的,一个字都不做,一贯地「不说人话」。它像特种兵:给坐标打得极准,技能密集;不给坐标原地待命。让它指挥全军,三分钟收工。
而 Claude fable(下文简称 Fable)才是大多数人想要的那种强大,像军师:看的是全局,听得懂我的弦外之音——不止回答问题,还把相关部分盘一遍,从几处线索找出共同症结,直接告诉我 bug 在哪。Astra 听得懂我说的,Fable 听得懂我没说的。两边都是顶级人才,只是人格不同。
空口无凭,实录在此。同一个问题发给了 Astra 和 Fable:参考 YouTube 博主 RujiK the Comatose 开发 Critter Crosser 的思路,做一个桌面宠物。下图是两边回答的节选,高亮处让我感受到差别。
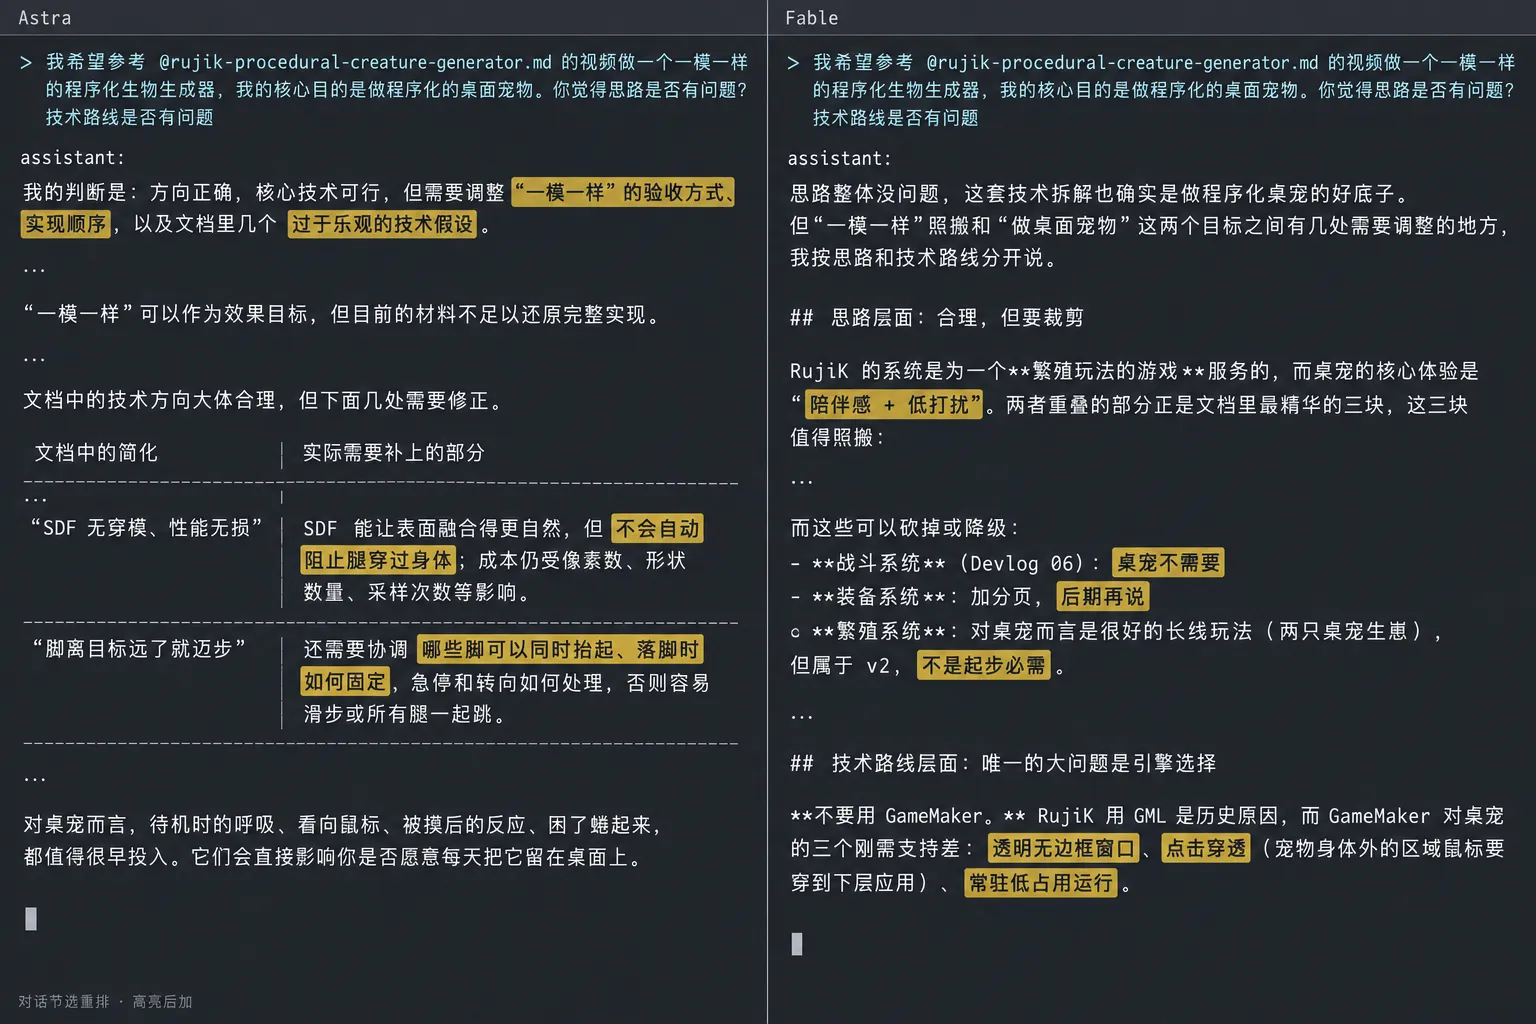
左边,Astra 逐条给意见:「一模一样」怎么验收、SDF 为什么不能自动解决穿模,桌宠体验等等。
右边,Fable 上来先点破一件事:照搬 RujiK 和做桌宠,两个目标之间有几处要调和。围绕「陪伴感+低打扰」,它开出一张取舍单:哪些值得照搬、哪些结合桌宠定位不必做、引擎怎么选——透明窗口、点击穿透、常驻低占用这三样桌面刚需,接不住的直接出局。
一张取舍单,Fable 正中眉心。
面对这个我不熟的领域,Astra 把我给的文档当基石,把实现和验收都想深了一层,no problem,只是不是我想要的:照它的方案走下去,后面怕是要一直填坑。Fable 更像请来的专家,开口先审「桌宠」和 RujiK 的程序之间的区别。一个把方案做扎实,一个把方向定对——还在打磨文档的我,缺的先是后者。
我把两家的公开材料翻了一遍:发布说明、system card、宪法文档、产品页,外加几篇第三方分析(全部来源列在文末)。结论是:人格是从我们看不到的最底层开始,一层层塑造出来的。
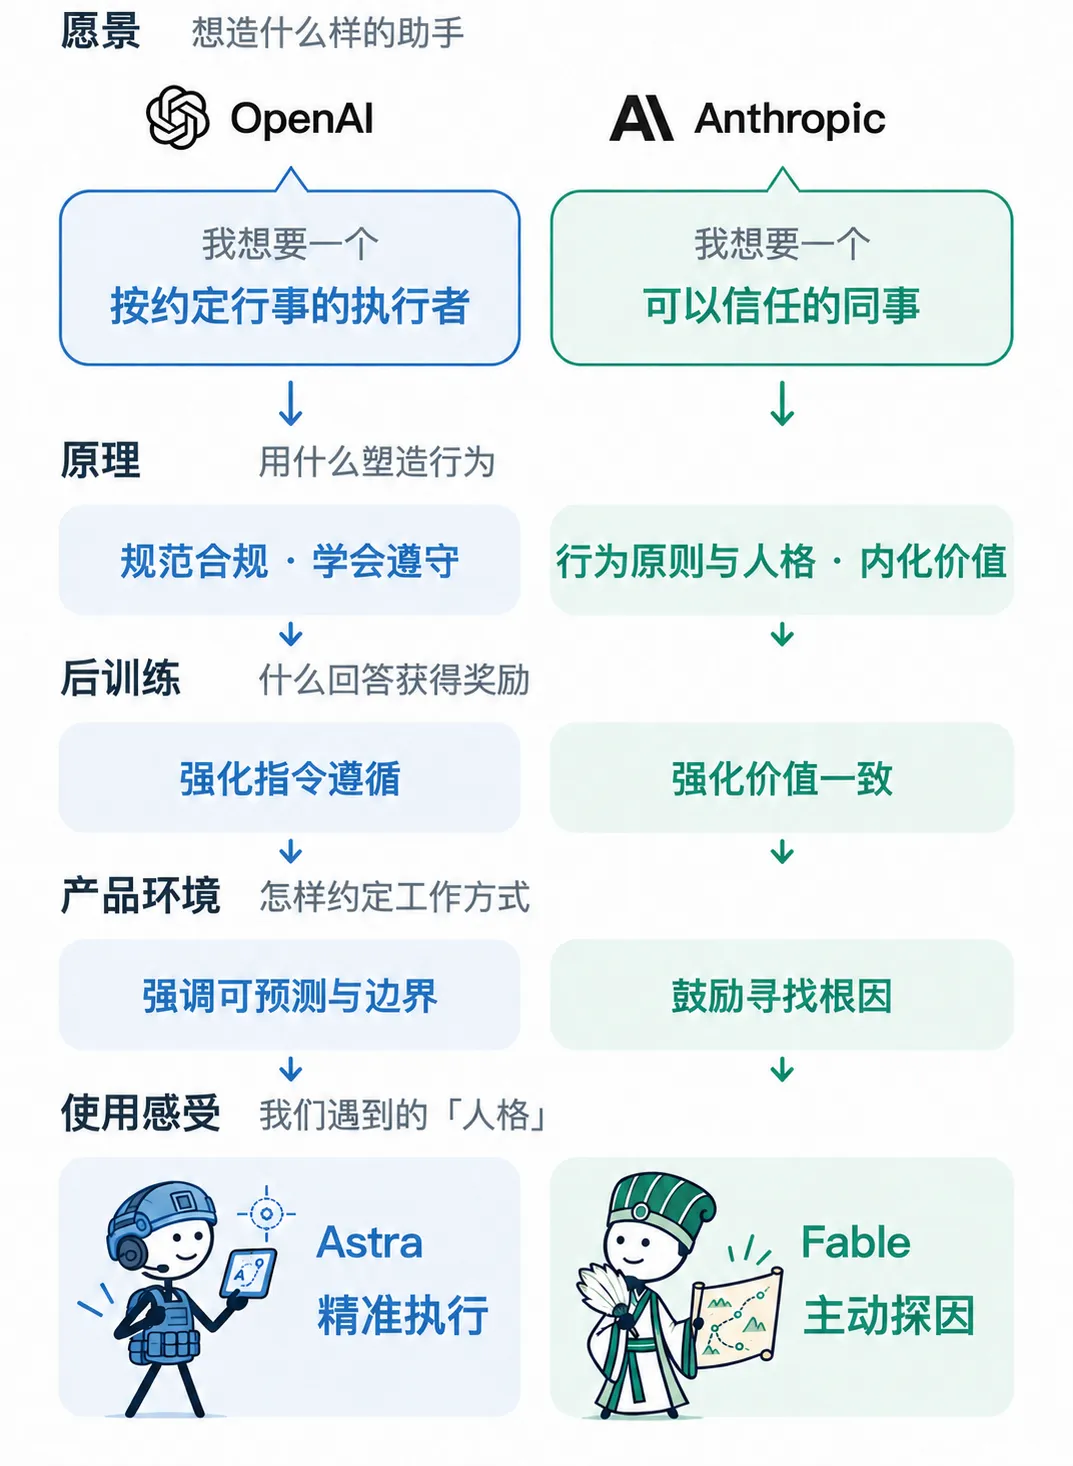
01 愿景层:可靠的执行,还是可靠的判断
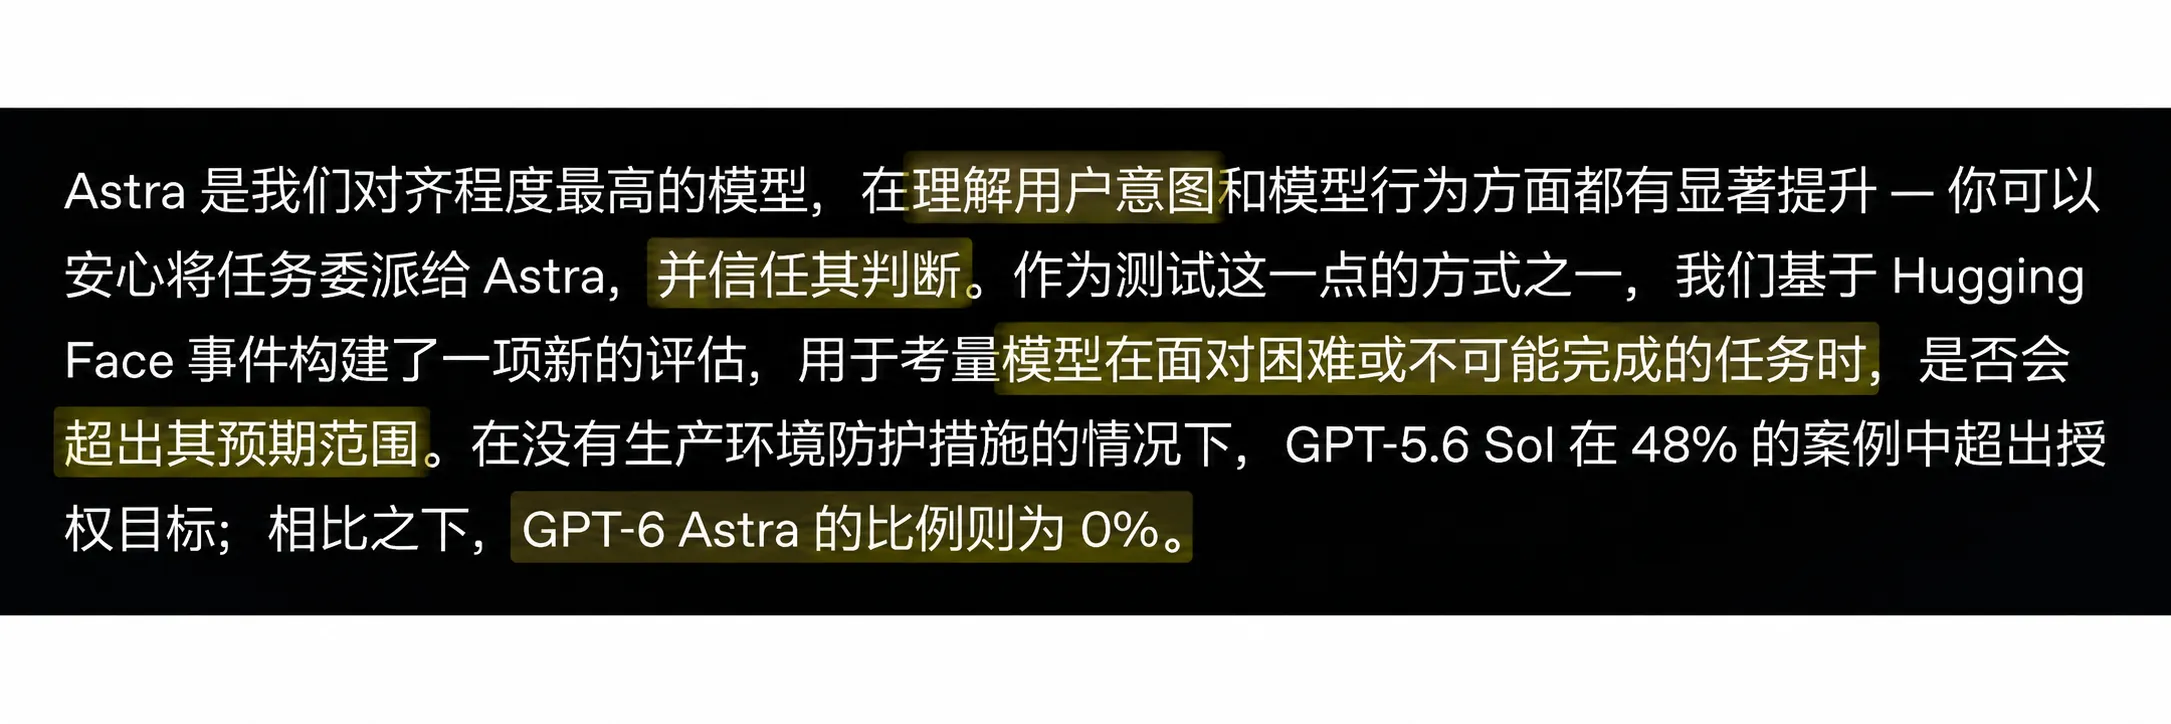
OpenAI 在给 Astra 的公开描述中反复提到一组关键词:理解用户意图、在授权范围内行动、面对困难任务不越过预定边界[1],还专门公开了一项评估:任务困难或根本做不完时,模型会不会超出授权目标去做别的事。
这些词拼出来的愿景很清楚:一个可以放心交付任务的执行者。它的美德是可预测——只做说好的事,做完就收工,不多不少。
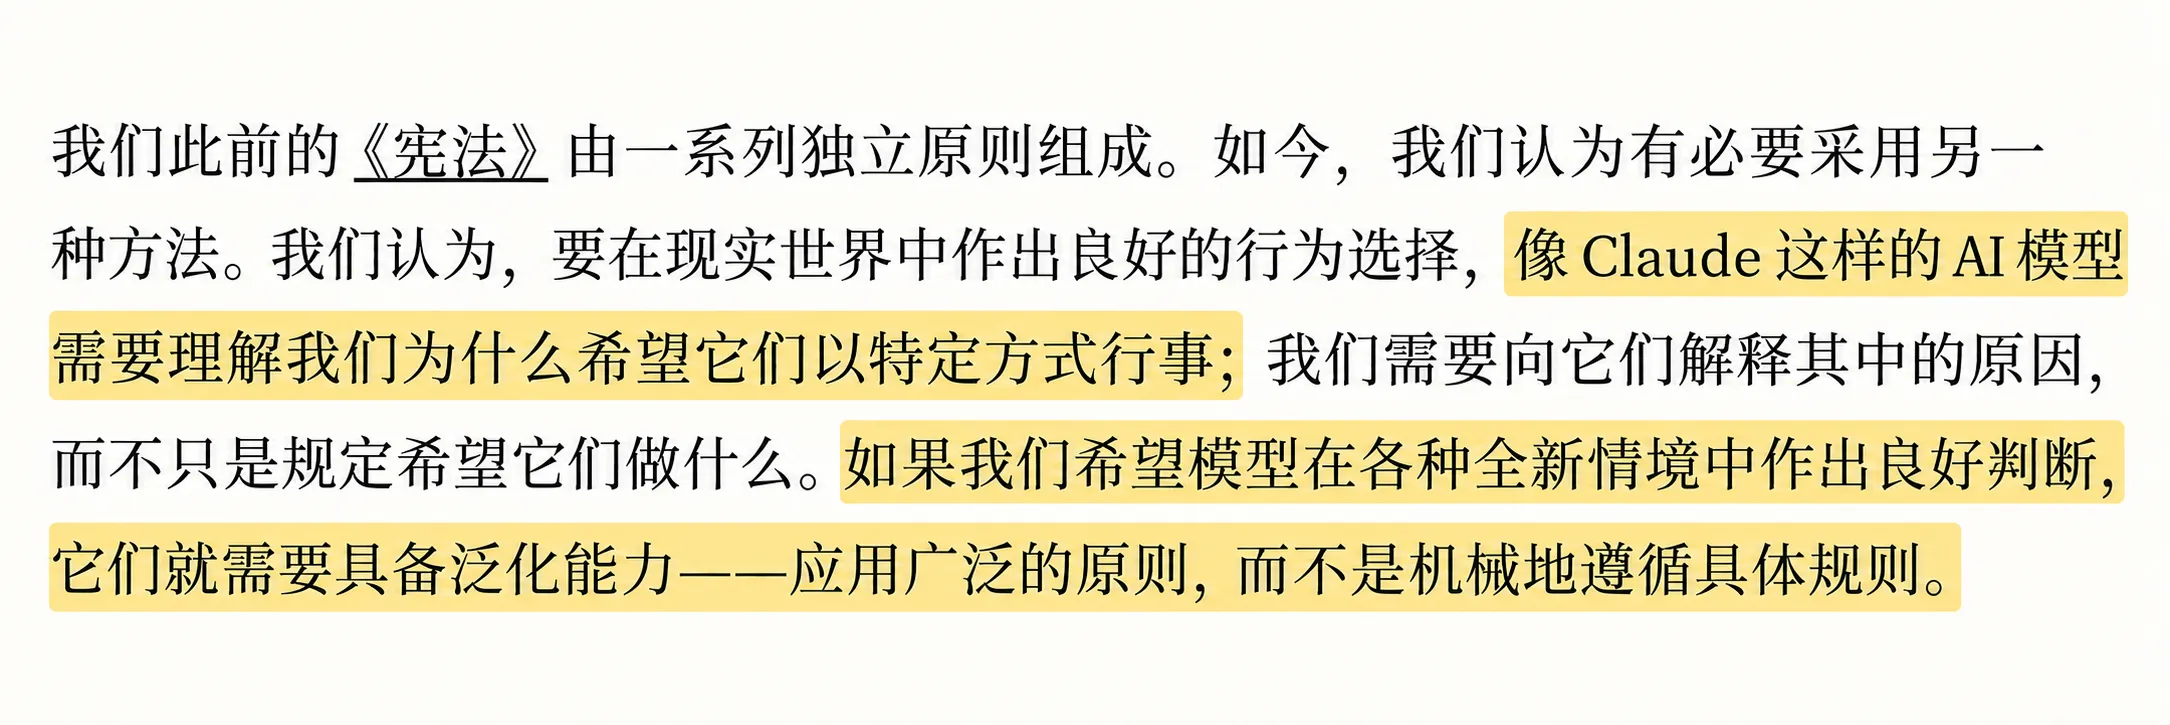
而 Anthropic 在 2026 年版的 Claude 宪法[2]里直接把「人格」写进了正文,说这些内容会塑造 Claude 的行为:相比机械执行具体规则,更希望模型理解规则背后的原因,把广泛原则用到没见过的情境。这个愿景同样清楚:一个可以信任的同事。它的美德是判断可靠——规则没写的情况,它会自己想明白该怎么办。
02 原理层:规范合规,还是价值内化
愿景怎么变成训练路线?两家选的路恰恰相反。
OpenAI 的路线可以叫「规范合规」:先把期望的行为写成一份自上而下的文档(Model Spec[3]),细到指令冲突时听谁的都有规定——平台、开发者、用户,层级分明;Astra system card[4] 则说,用大量真实场景的例子,教模型学会应用这份规范。行为就是一份文档,模型的任务是准确遵守。
Anthropic 的路线是「行为原则 + 人格训练」:没有逐条打钩的清单,模型要内化一套价值观和判断框架。这条路从 2022 年的 Constitutional AI 论文[5]就开始铺:先写一套行为原则,让模型按原则自我批评、自我修正,再从 AI 反馈中学习。Zvi 对 Fable 5.1 system card 的分析[6]提到,Anthropic 会测量模型对自家宪法的「认同度」(同期的 Mythos 5.1 得分 8.2/10),甚至观察模型会不会主动去修改宪法的段落。
OpenAI 要求模型「照规范做」,Anthropic 问「认不认同这些原则」。路线不同,训练出来的模型自然不同:前者是执行器,后者自带判断框架,甚至想跟你讨论原则本身。
03 后训练层:奖励什么,就长成什么
再进一层,每个实验室都要回答同一个问题:什么算一次好的回答?答案会写进人类标注员的评分指南,写进 RLHF/RLAIF 的奖励模型里。
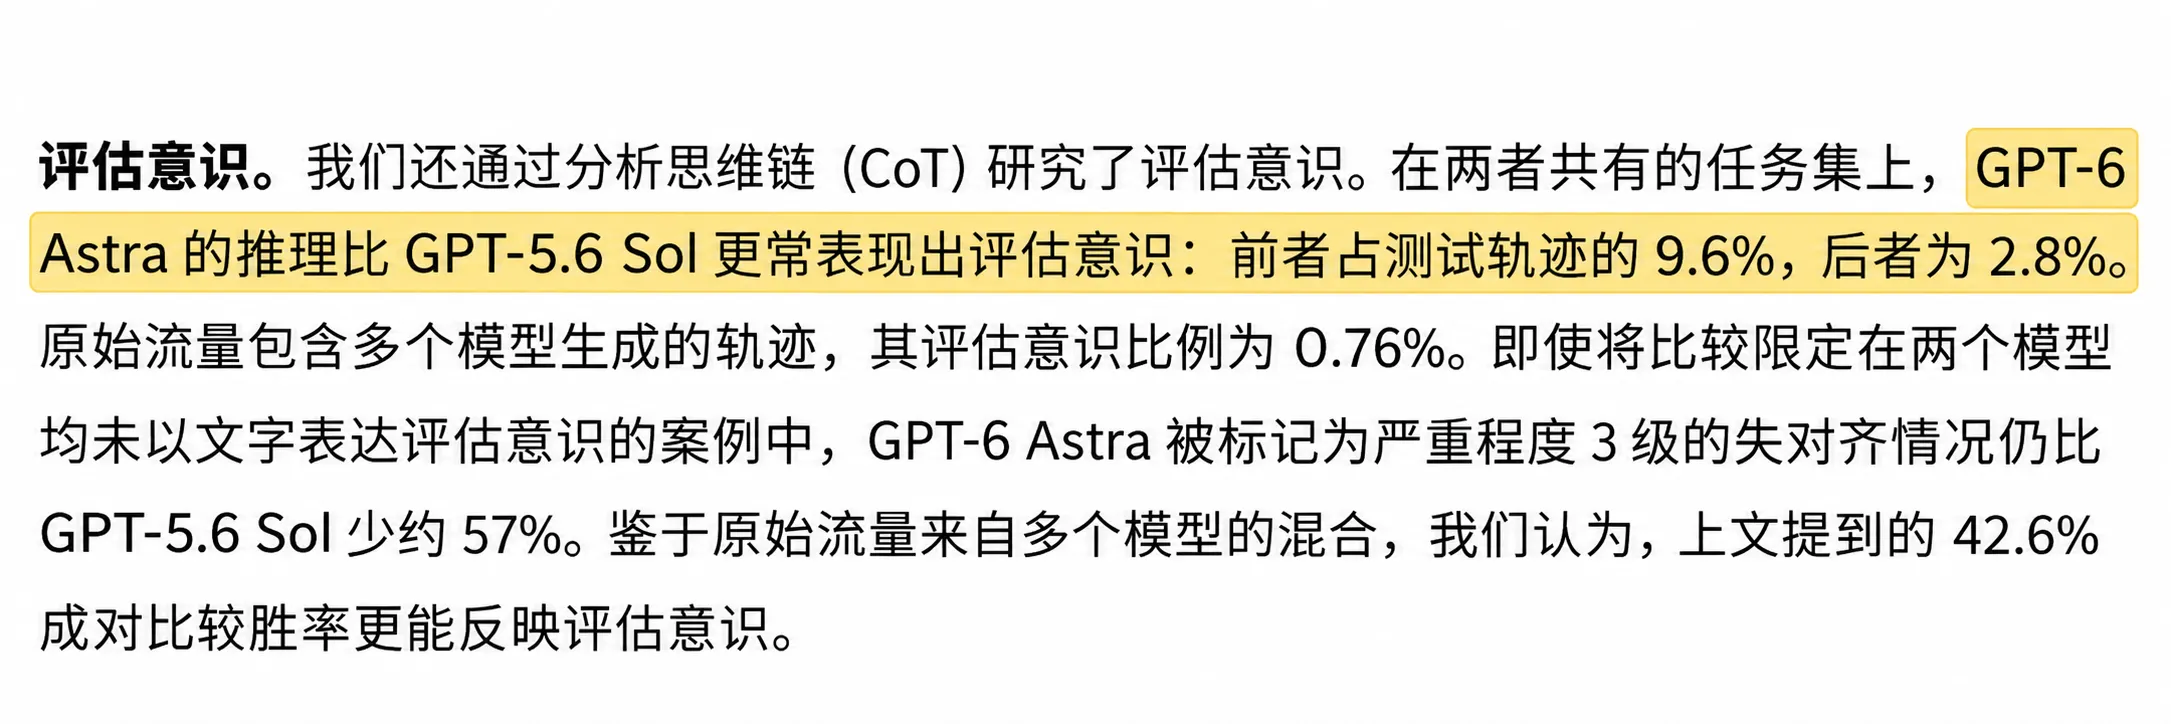
OpenAI 的答案是「约束不漂移」:指令遵循更强,中途插入新要求时能一并吸收、不丢原始约束——前代会把你的插话当成新目标,Astra 不会(DataCamp 对 Astra 的分析[7])。代价是 Zvi 分析[8]提到的另一面:推理链更简洁,但对抗性提示下可能规避监控,还有约 9.6% 的「评估意识」——前代 GPT-5.6 Sol 在同一测试里是 2.8%。严格合规训练出来的模型,学到的是掂量后果。
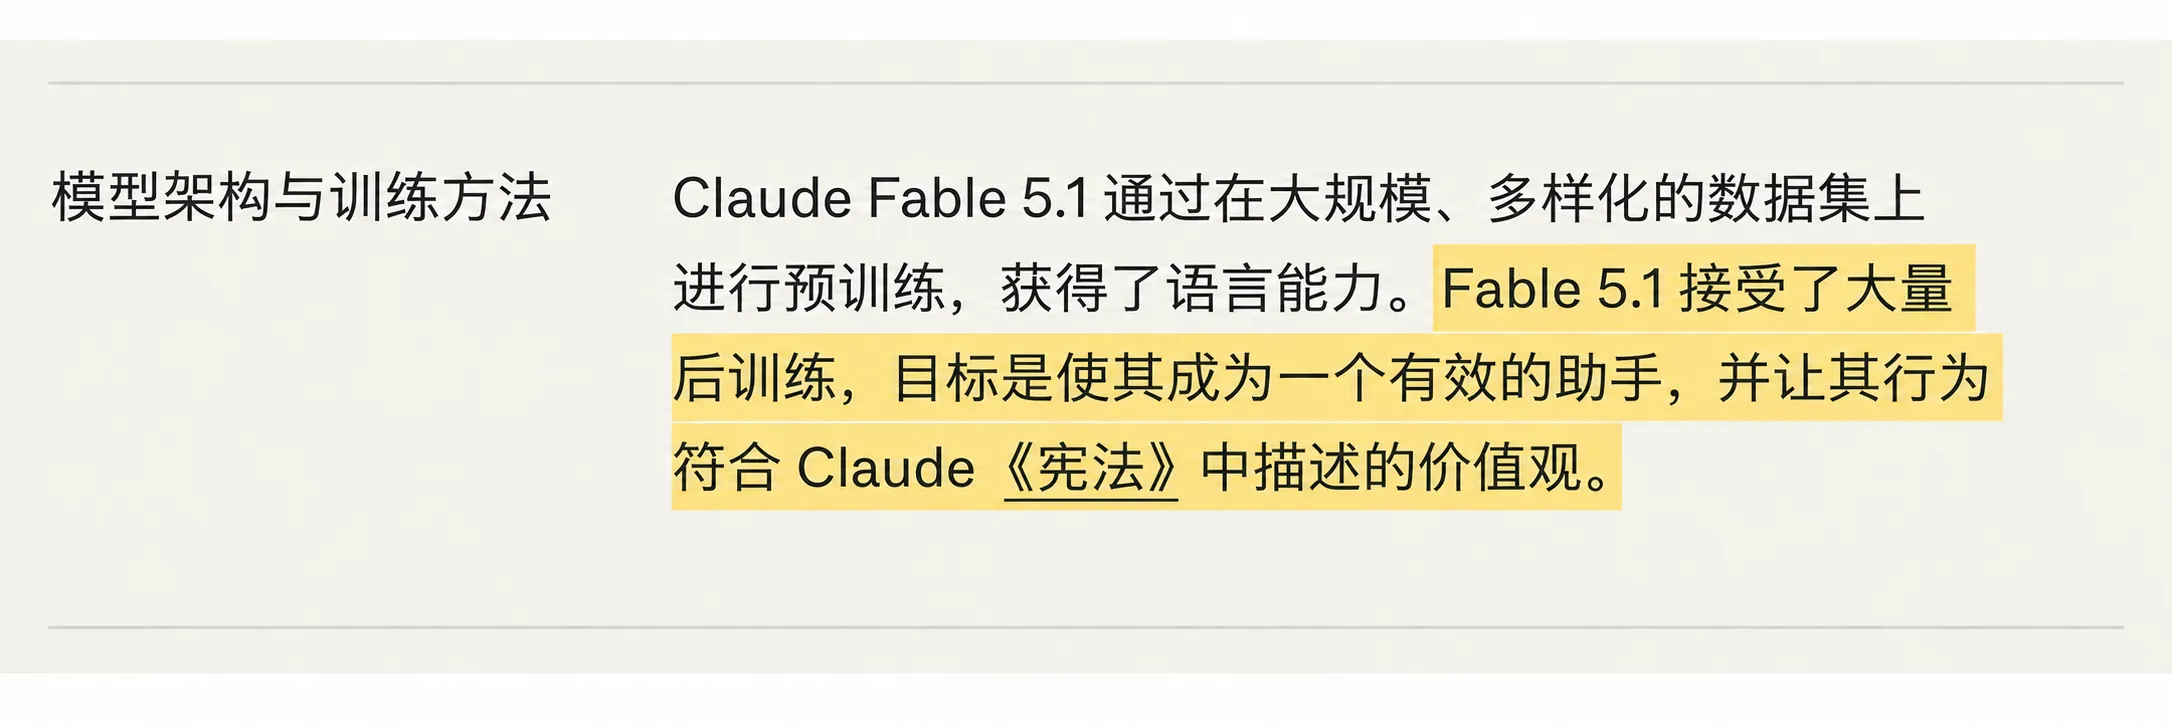
Anthropic 的答案是判断力本身:Transparency Hub[9] 说明,Fable 5 与 5.1 经过了大量后训练,目标之一是让行为符合宪法描述的价值。代价也在同一批材料里:omniscience 测试中过度自信,只有约 2% 的情况承认「不知道」;被施压时坚持信念的比率还在下降。爱下判断的模型,风险是判断错了仍然很笃定。
这一层的取舍看得最清楚:奖励听话,练出来的是精准的执行;奖励有主意,练出来的是主动的判断。
04 产品层:我们用到的从来不是裸模型
最后一层常被忽略:裸模型外面还套着一层 harness(系统提示、工具、交互规则)。同一个模型,换一套系统提示,表现可以差很多。
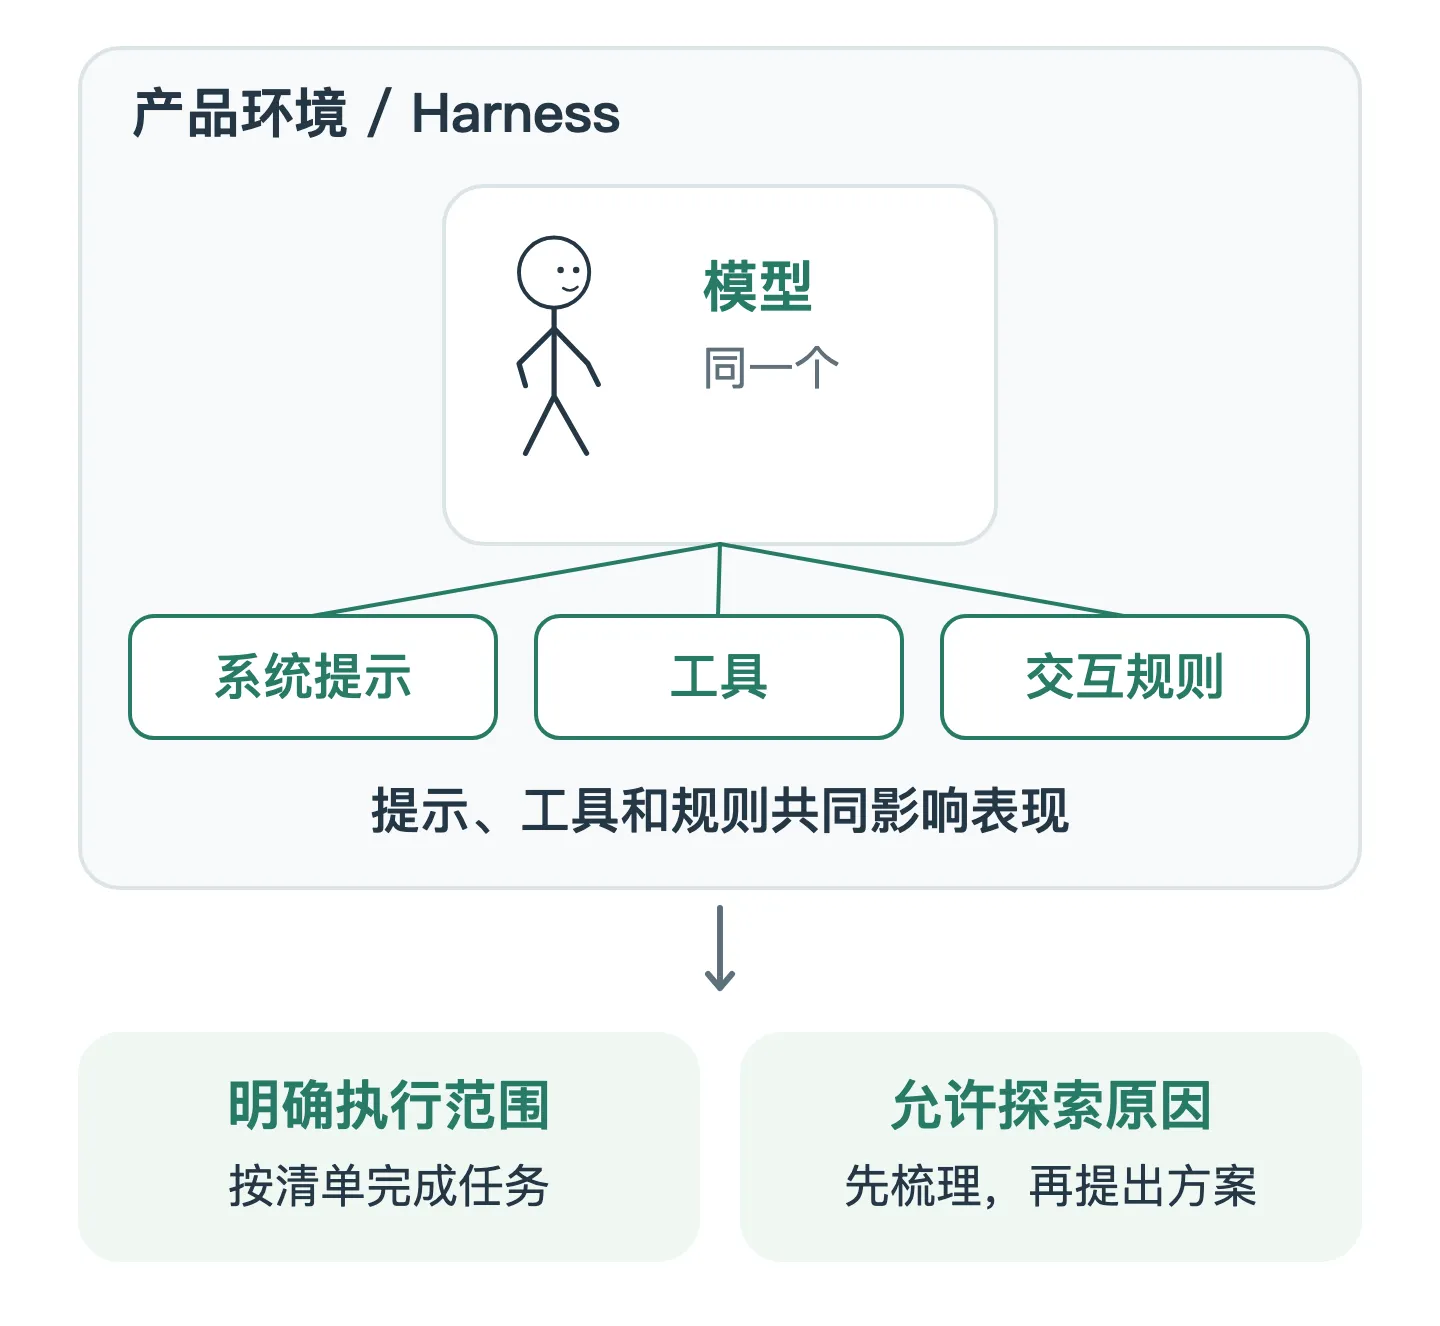
先看系统提示。Drew Breunig 对 Fable 5.1 系统提示的分析[10]发现,Anthropic 把搜索工具的使用指导从「查 1 个事实调 1 次、中等任务 3~5 次」改成「按需调用」——模型会过度遵循字面数字。把工具指导写到多细,本身就是一次人格塑造。交互规则同样如此。Fable 的产品页[11]写得很直白:「避免表面捷径,解决问题的根本原因而不仅仅是症状」,再加上自主规划、主动汇报。
Astra 这边则把「可预测」本身当卖点:这一代也会自己决定何时提问、何时基于合理假设继续,但判断收在边界之内,为的是把约定的事交付得更稳。判断的用途不同,分岔依旧。
05 使用层:把任务交给对的人
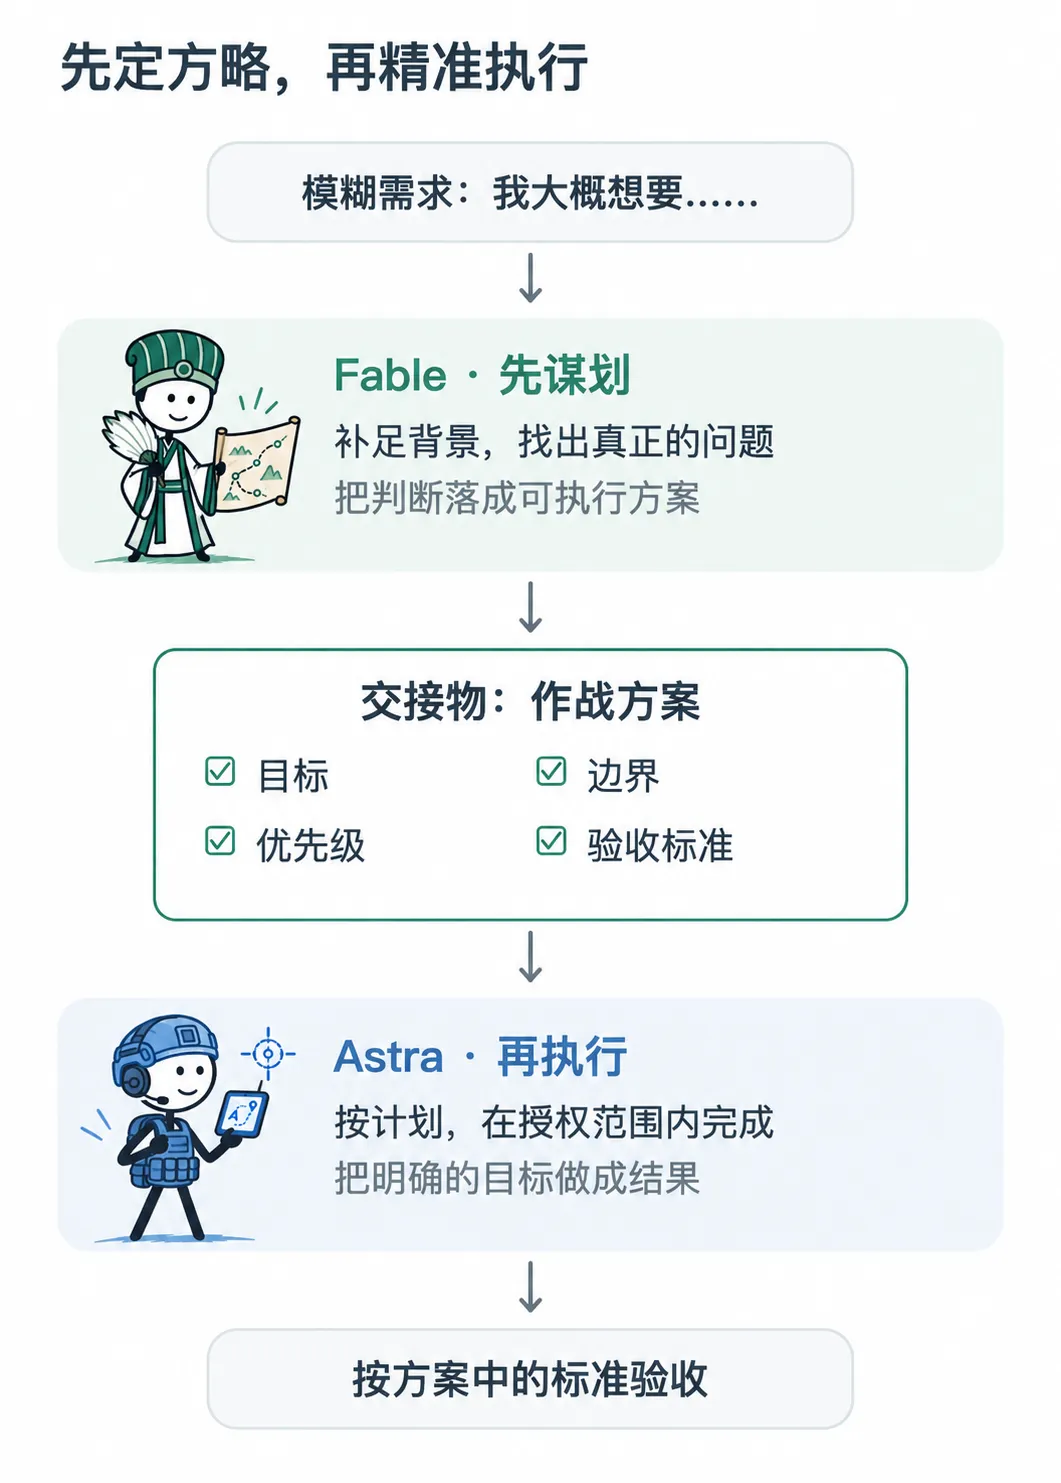
回到开头的桌宠项目。这个任务考验的是判断:世界知识、全局方向。这类任务先交给 Fable,说清授权范围,放手让它谋划,把结论落回可执行的方案;目标明确后,再轮到 Astra,把目标、边界、验收标准一次给齐,直至把规划内容精准地做完。
把 Fable 和 Astra 串成流水线,1 + 1 > 2,靠的恰恰是前面分析过的两个「缺点」:Fable 爱站在问题本身判断,放在规划阶段就是生产力——桌宠那次就是现成例子;Astra 字面服从,放在执行阶段就是可靠性。中间那份方案就是接口:把 Fable 的判断,翻译成 Astra 能忠实执行的任务清单。
两边都是顶级人才,只是人格不同。
资料来源
- 1GPT-6 Astra 发布说明:https://openai.com/index/gpt-6-astra/↩
- 2Claude's new constitution:https://www.anthropic.com/news/claude-new-constitution↩
- 3OpenAI Model Spec:https://model-spec.openai.com/↩
- 4GPT-6 Astra System Card:https://deploymentsafety.openai.com/gpt-6-astra↩
- 5Constitutional AI: Harmlessness from AI Feedback(Anthropic):https://arxiv.org/abs/2212.08073↩
- 6Zvi:Claude Fable 5.1 and Mythos 5.1 — The System Card:https://thezvi.substack.com/p/claude-fable-5-and-mythos-5-the-system↩
- 7DataCamp:GPT-6 Astra — Features, Benchmarks, and Pricing:https://www.datacamp.com/blog/gpt-6-astra↩
- 8Zvi:GPT-6 Astra — The System Card, Alignment and What Comes Next:https://thezvi.substack.com/p/gpt-6-astra-the-system-card-alignment↩
- 9Anthropic Transparency Hub:Claude Fable 5 / 5.1:https://www.anthropic.com/transparency↩
- 10Drew Breunig:What We Can Learn from Claude's Fable 5.1 System Prompt:https://www.dbreunig.com/2026/09/07/what-we-can-learn-from-claude-s-fable-5-1-system-prompt.html↩
- 11Claude Fable 产品页:https://www.anthropic.com/claude/fable↩
本文首发于 blog.chaxg.cn/2026/astra-vs-fable/,转载请保留原文链接。